Co je kanonický odkaz
Představte si knihu, která v knihovně stojí v pěti exemplářích. V katalogu je ale jen jeden záznam, ke kterému se všechny výpůjčky a hodnocení počítají. Kanonický odkaz je pro webovou stránku totéž: určuje, která adresa je hlavní verze stránky.
V kódu stránky je to jeden řádek v hlavičce (části <head>):
<link rel="canonical" href="https://www.example.cz/clanek/">Návštěvník ho nevidí, čtou ho jen vyhledávače. Slovo „kanonický“ tu znamená „závazný, vzorový“, stejně jako u kanonického textu.
Proč vůbec existuje
Pro člověka je to jedna stránka, pro vyhledávač ale každá adresa znamená samostatnou stránku. Přitom stejný obsah se často zobrazí na mnoha adresách:
https://www.example.cz/clanek/ahttps://example.cz/clanek/(s www a bez),http://ahttps://,- s lomítkem na konci a bez něj,
https://example.cz/clanek/?utm_source=facebook, tedy adresa s parametrem, který přidají sociální sítě nebo reklamy,- verze pro tisk, seřazený nebo filtrovaný výpis.
Bez kanonického odkazu musí vyhledávač sám hádat, kterou adresu ukázat ve výsledcích. Odkazy z jiných webů se navíc rozdělí mezi několik kopií.
Kanonický odkaz není nový nápad. Google ho představil 12. února 2009 a jeho podporu ve stejné době oznámily také Yahoo, Microsoft a Ask.com. V dubnu 2012 ho popsal dokument RFC 6596, jehož autory jsou Maile Ohye a Joachim Kupke z Googlu.
Jak to funguje
Google stránky se stejným nebo velmi podobným obsahem seskupí a z každé skupiny vybere jednu reprezentativní adresu, kterou indexuje a ukazuje ve výsledcích. Kanonický odkaz mu při tom pomáhá, ale nic nepřikazuje. I když kanonickou stránku výslovně určíte, Google může z různých důvodů zvolit jinou, například kvůli kvalitě obsahu nebo technickým signálům.
Signály mají různou sílu. Dokumentace Googlu řadí přesměrování a rel="canonical" mezi silné signály a uvedení adresy v sitemapě mezi slabé. Roli hrají i odkazy uvnitř webu: když web sám odkazuje na jednu adresu, Google to bere jako další nápovědu.
Na většině dobře udělaných webů odkazuje každá stránka kanonickým odkazem sama na sebe. Zní to zbytečně, ale má to smysl: když někdo stránku sdílí s parametrem ?utm_source=..., kopie s parametrem nese stejný kanonický odkaz a všechno se započítá k hlavní adrese.
Kanonický odkaz smí ukazovat jen na stránku se stejným obsahem. Podle RFC 6596 musí být cílová stránka duplikátem odkazující stránky, nebo obsahovat ještě víc.
V čem pomůže
- Sečtou se signály. Podle Googlu kanonický odkaz pomáhá sloučit signály jednotlivých adres, například odkazy, které na ně vedou, do jedné preferované adresy.
- Ve výsledcích vyhledávání se ukáže správná adresa, ne kopie s parametrem z Facebooku.
- Vyhledávač neztrácí čas procházením kopií a víc se věnuje skutečně novým stránkám.
Zároveň je potřeba nepřehánět: podle Googlu obecně není zásadní kanonickou adresu určovat. Malý web s jednoduchými adresami bez něj nezanikne. Problém nastane hlavně tehdy, když je kanonický odkaz nastavený špatně.
Co se stane, když se to udělá špatně
Chyba v kanonickém odkazu se na webu nijak neprojeví, stránka vypadá normálně. Dozvíte se o ní až z poklesu návštěvnosti nebo ze Search Console. Nejčastější chyby:
Všechny stránky ukazují na úvodní stranu
Typicky vznikne zkopírováním šablony, ve které zůstala adresa úvodní strany. Google na to přímo upozorňuje: pokud používáte šablonu, zkontrolujte, že jste nezkopírovali i specifikaci rel=canonical. V lepším případě Google značku ignoruje, v horším stránky bere jako kopie úvodní strany a samostatně je neindexuje.
Stránkování ukazuje na první stranu
Druhá a třetí strana výpisu mají jiný obsah než první, nejsou to kopie. Google řadí kanonický odkaz směřující na první stranu stránkované řady mezi pět nejčastějších chyb. Články, na které se odkazuje až z dalších stran, pak vyhledávač hůř najde.
Chybějící https:// na začátku
Zápis href="example.cz/clanek/" prohlížeč i vyhledávač chápou jako relativní adresu a připojí ji k té současné. Vznikne nesmysl typu https://example.cz/clanek/example.cz/clanek/, tedy odkaz na stránku, která neexistuje. Proto Google doporučuje psát vždy celou adresu.
Dva kanonické odkazy na jedné stránce
Častá chyba webů na WordPressu a podobných systémech, kde jeden odkaz vloží šablona a druhý plugin. Při více deklaracích Google nejspíš ignoruje všechny a přínos správného kanonického odkazu se ztratí.
Kanonický odkaz mimo hlavičku
Kanonický odkaz v těle stránky (<body>) Google nebere v úvahu. Stát se to může i nechtěně: chybně uzavřená značka v hlavičce ji předčasně ukončí a kanonický odkaz za ní se ocitne v těle stránky.
Odkaz na stránku, která nefunguje
Kanonický odkaz na stránku s chybou 404, na adresu, která dál přesměrovává, nebo na stránku označenou noindex posílá vyhledávači protichůdné pokyny.
Rozpor se sitemapou
Google radí neuvádět pro stejnou stránku jednu adresu v sitemapě a jinou v rel="canonical".
Napadený web
Méně známé, ale nebezpečné: některé útoky vloží do webu kód, který přidá kanonický odkaz na cizí doménu, obvykle na stránku se škodlivým obsahem nebo spamem. Algoritmus pak může zvolit škodlivou adresu místo adresy napadeného webu.
Jak si to zkontrolovat
Ve zdrojovém kódu. Otevřete stránku, zobrazte zdrojový kód (ve většině prohlížečů Ctrl+U) a vyhledejte slovo canonical. Měl by tam být právě jeden výskyt, v hlavičce, s celou adresou včetně https://, a měl by vést na správnou stránku.
V Google Search Console. Nástroj Kontrola URL ukáže dvě adresy: kanonickou adresu, kterou jste určili vy, a tu, kterou zvolil Google. Když se shodují, je všechno v pořádku.
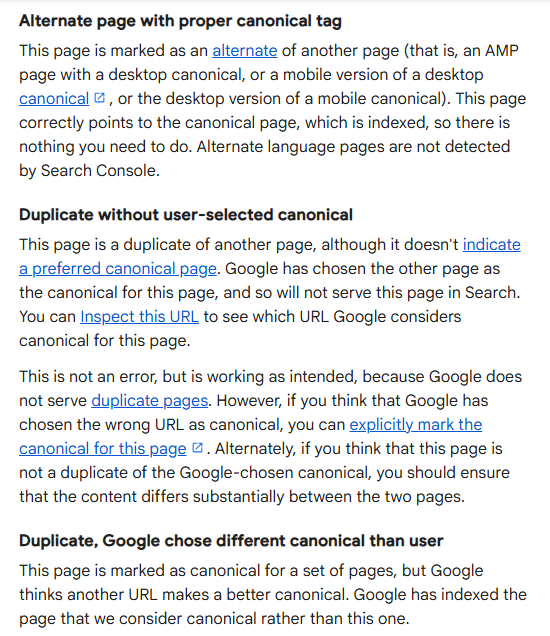
V přehledu Indexování stránek najdete u neindexovaných stránek několik stavů, které se kanonických odkazů týkají. Podle nápovědy Googlu znamenají:
- Alternativní stránka se správnou kanonickou značkou: stránka správně odkazuje na hlavní verzi, ta je zaindexovaná a není potřeba nic dělat.
- Duplicitní stránka bez kanonické verze vybrané uživatelem: Google našel kopii a hlavní verzi si vybral sám. Není to chyba. Pokud vybral špatně, určete kanonickou adresu sami.
- Duplicitní, Google zvolil jinou kanonickou stránku než uživatel: vy jste určili jednu adresu, ale Google považuje za lepší jinou. Tady se vyplatí zpozornět. Pokud stránka, na kterou kanonický odkaz vede, není podobná té současné, Google ji jako kanonickou nikdy nezvolí.
- Stránka s přesměrováním: adresa přesměrovává jinam, takže se sama neindexuje. Pokud jde o úmysl, je to v pořádku.
Po opravě je potřeba trpělivost: i po vyřešení problému může Google držet stránky ve skupině duplikátů až dva týdny.
Shrnutí
Kanonický odkaz je malý, ale důležitý detail. Dobře nastavený sjednotí kopie stránky pod jednu adresu a sečte jim body. Špatně nastavený umí z vyhledávání tiše vyřadit stránky, o které vám jde nejvíc. Stačí pravidlo: jeden odkaz na stránku, v hlavičce, s celou adresou a vždy na stránku se stejným obsahem.
Zdroje
- How to specify a canonical URL with rel="canonical" and other methods (Google Search Central)
- Fix canonicalization issues (Google Search Central)
- 5 common mistakes with rel=canonical (Google Search Central Blog, 2013)
- Specify your canonical (Google Search Central Blog, 2009)
- Page indexing report (nápověda Search Console)
- RFC 6596: The Canonical Link Relation (IETF, 2012)
Zpracováno podle stavu k listopadu 2026.